
Table of Contents
Les agents IA transforment déjà la sécurité offensive. Nous avons développé un framework ouvert pour aider les chercheurs à les utiliser tout en gardant la maîtrise du périmètre des tests, des preuves et de la qualité des rapports.
Les agents IA font déjà partie des pratiques de sécurité offensive.
Les chercheurs utilisent des outils comme Claude Code, Codex, Cursor ou Windsurf pour analyser des applications, explorer des chemins d’attaque et les aider à rédiger leurs rapports de vulnérabilité. Ces outils accélèrent les recherches et permettent de mener des investigations plus efficacement.
Mais à mesure que leur adoption progressait, nous avons commencé à observer certaines dérives.
Des agents pouvaient poursuivre leurs tests au-delà du périmètre autorisé. Réaliser des actions inutilement destructrices pour démontrer un impact. Accéder à de véritables données utilisateurs alors que des comptes de test auraient suffi. Ou encore transformer une vulnérabilité de criticité Medium en Critical, en évaluant ce qui pourrait se produire plutôt que ce qui avait réellement été démontré.
Le problème n’était pas que les chercheurs utilisaient des agents IA.
Le problème, c’est que personne n’avait donné à ces agents les règles du jeu.
Nous avons donc décidé de le faire.
Ne plus corriger les rapports a posteriori, mais guider les agents en amont
Le Bug Bounty repose sur des règles qui peuvent sembler évidentes pour un chercheur expérimenté, mais qui ne le sont pas nécessairement pour un agent IA.
Respecter le périmètre autorisé. Ne pas causer de dommages. Ne pas accéder aux données réelles des clients lorsque ce n’est pas nécessaire. Démontrer une vulnérabilité plutôt qu’extrapoler son impact. Attribuer un score sur la base de ce que l’on peut prouver. Produire un rapport dont un autre expert pourra reproduire les étapes.
Plutôt que de traiter ces problématiques après les tests, au moment du triage, nous avons souhaité intervenir plus tôt dans le processus.
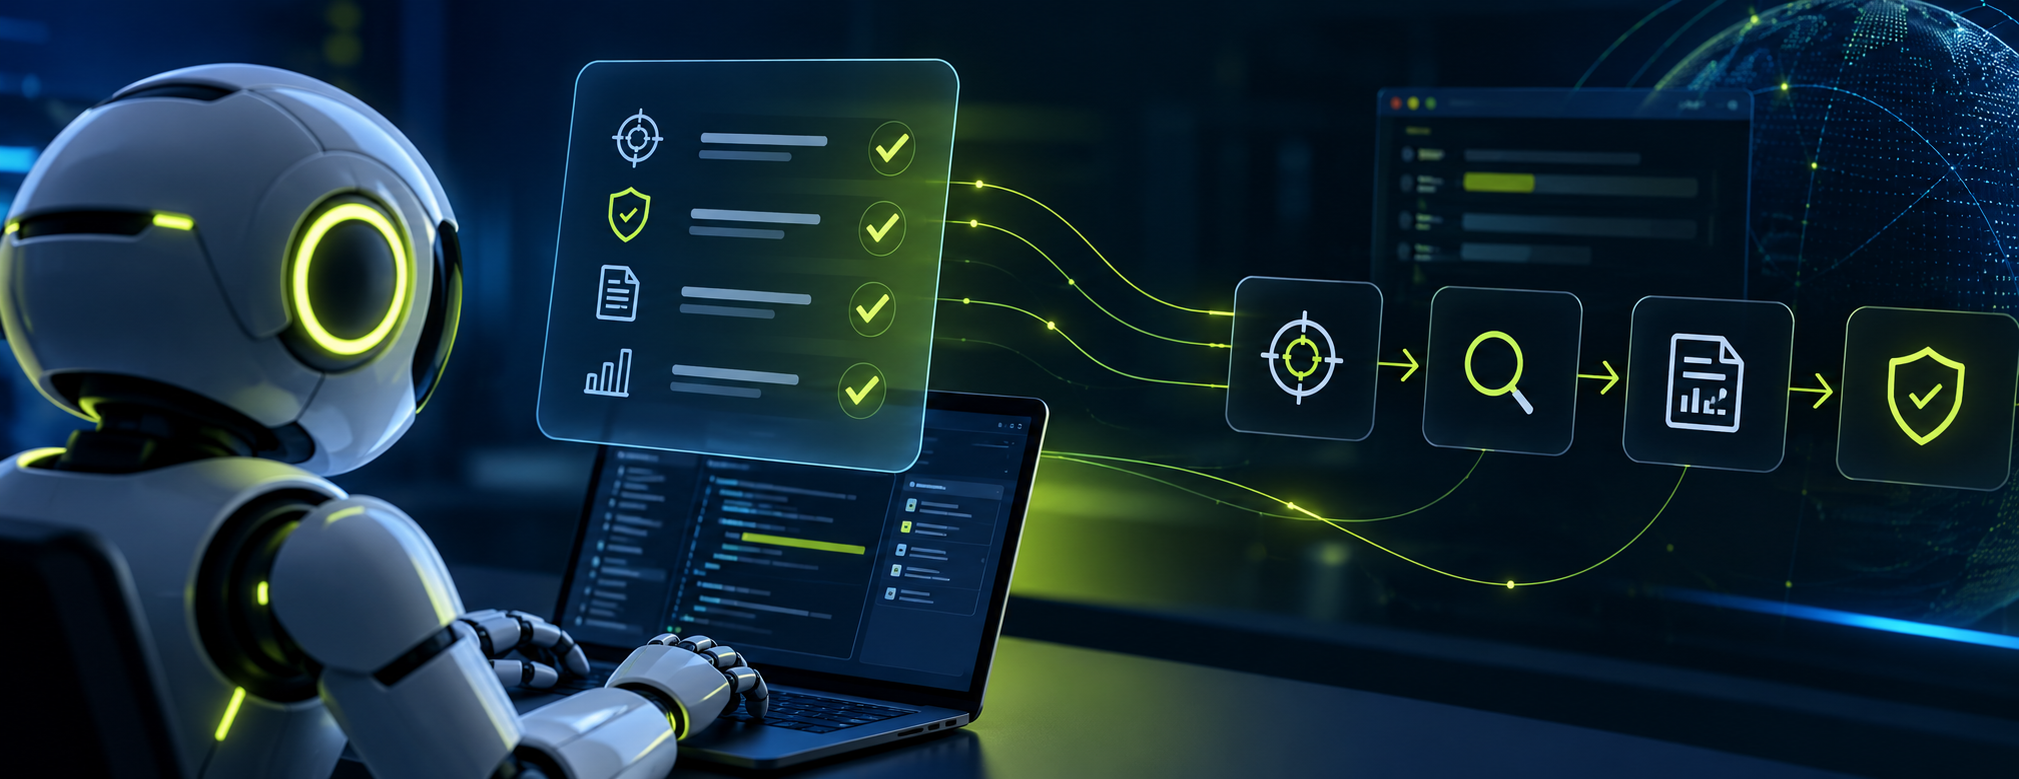
C’est ainsi qu’est née la Yogosha Skill : un ensemble commun de règles d’engagement et de consignes relatives à la qualité des rapports, qu’un agent IA peut charger avant de commencer à travailler.
L’objectif est double : guider l’agent vers des tests non destructifs, respectueux du périmètre autorisé, et améliorer la qualité des rapports grâce à des preuves plus robustes, des tests de contrôle et des scores CVSS mieux justifiés.
Et cette approche ne dépend ni d’un modèle ni d’un fournisseur en particulier.
Une source unique, six intégrations d’agents IA
La plupart des agents de développement disposent d’un mécanisme permettant de charger des instructions propres à un projet.
Codex et OpenAI CLI peuvent lire un fichier AGENTS.md. Cursor dispose de règles spécifiques au projet. Windsurf et Continue possèdent leurs propres formats. Pour un agent reposant directement sur une API, ces mêmes instructions peuvent être transmises sous forme de message système. Claude Code peut quant à lui utiliser le plugin Yogosha complet ou directement ses règles.
Au cœur du projet se trouve un fichier : RULES.md.
Il constitue la source de référence unique.
Les versions propres à chaque agent sont générées à partir de ce fichier, afin de garantir une méthodologie cohérente quel que soit l’outil utilisé.
Aujourd’hui, le projet couvre six implémentations : Claude Code, Codex/OpenAI CLI, Cursor, Windsurf, Continue et les agents reposant directement sur une API.
Une source. Six intégrations. Aucune divergence méthodologique.
Mais le plus important n’est pas l’endroit où ces règles sont définies. C’est la manière dont elles modifient le comportement de l’agent.
Prouver la vulnérabilité plutôt que simplement la décrire
L’un des principes fondamentaux de la Skill repose sur ce que nous appelons la load-bearing proof, autrement dit la preuve décisive.
Pour chaque vulnérabilité, il existe une étape déterminante qui permet d’en démontrer réellement l’existence.
Prenons l’exemple d’une faille d’autorisation. Montrer qu’un endpoint existe ne suffit pas. Le rapport doit démontrer qu’un accès non autorisé a effectivement eu lieu.
Si la preuve de cette étape décisive n’a pas été collectée, l’agent ne doit pas rédiger son rapport comme si la vulnérabilité avait été démontrée.
Un impact potentiel reste un impact potentiel.
La Skill demande également à l’agent de réaliser des tests de contrôle négatifs en complément des résultats positifs. Un identifiant invalide renvoyant une erreur 404, l’identifiant d’un autre utilisateur renvoyant une erreur 403 ou un token altéré provoquant une erreur peuvent permettre de confirmer qu’un test réussi révèle un véritable problème de sécurité, et non un effet de cache, de routage ou du comportement par défaut de l’application.
Le principe est simple :
Ce que l’on affirme doit être démontré.
Une vulnérabilité critique doit mériter son score
Les rapports générés par l’IA peuvent être extrêmement convaincants.
Cela devient problématique lorsque l’assurance avec laquelle ils sont rédigés dépasse la solidité des preuves sur lesquelles ils reposent.
La Skill remet donc systématiquement en question le vecteur CVSS 4.0 proposé. L’agent examine chaque métrique et exige des preuves collectées lors des tests pour justifier des valeurs High ou Critical. L’impact démontré et l’impact hypothétique doivent rester clairement distincts.
Si les preuves ne permettent pas de justifier une métrique, le score doit être ajusté et la raison de cet ajustement explicitée.
Notre règle d’or :
Mieux vaut une vulnérabilité Medium solidement argumentée qu’une Critical rejetée.
Pour le chercheur, cela signifie produire un rapport plus facile à défendre. Pour les équipes de triage, c’est moins de temps passé à remettre en question des hypothèses non démontrées. Et pour le client, c’est l’assurance de recevoir une évaluation de la criticité fondée sur un impact effectivement démontré.
Des tests non destructifs par défaut
Le respect du périmètre et le comportement de l’agent pendant les tests constituent un autre pilier de la Skill.
L’agent reçoit pour consigne de rester dans le périmètre autorisé du programme et d’utiliser les propres comptes de test du chercheur.
Pas de brute force. Pas de déni de service. Pas d’accès inutile aux données réelles des clients. Toute modification effectuée pendant les tests doit être annulée afin de rétablir l’état initial.
Et si la démonstration d’une vulnérabilité nécessite une action destructrice, l’agent doit s’arrêter et décrire les étapes permettant une validation manuelle sécurisée, plutôt que d’exécuter lui-même cette action.
Cette distinction est importante, car un agent IA peut être particulièrement efficace lorsqu’il s’agit d’atteindre un objectif.
En revanche, il ne sait pas intrinsèquement à quel moment poursuivre cet objectif devient inacceptable.
Du test au rapport de vulnérabilité
Pour Claude Code, nous sommes allés au-delà d’un simple ensemble d’instructions.
Le plugin Yogosha peut accompagner le chercheur tout au long du processus de préparation de son rapport.
À partir des notes du chercheur, l’agent peut vérifier le périmètre autorisé, définir la preuve décisive à obtenir et les tests de contrôle associés, guider la réalisation de tests non destructifs, challenger le score CVSS, structurer le rapport et le relire en adoptant le point de vue d’un expert en triage.
Lorsque le rapport est prêt, il peut créer un brouillon sur la plateforme Yogosha, après confirmation explicite du chercheur. Une fois les preuves ajoutées, il peut également vérifier la présence des captures d’écran et de la vidéo attendues avant la soumission du rapport.
Le plugin peut se connecter à la plateforme via le serveur MCP officiel de Yogosha.
Le MCP, ou Model Context Protocol, permet à un agent IA d’interagir avec des outils externes. Dans ce cas, il lui donne accès à des fonctionnalités telles que la consultation d’un programme et de son périmètre, ou encore la gestion des propres rapports du chercheur.
Tout au long de ce processus, un principe reste inchangé :
L’agent prépare. Le chercheur décide.
Toute action d’écriture ou de modification sur la plateforme nécessite une confirmation explicite. La soumission du rapport reste une décision humaine.
Un garde-fou comportemental, pas une barrière de sécurité
Il est important de souligner les limites de cette approche.
La Yogosha Skill n’est ni une sandbox ni un mécanisme de contrôle de sécurité.
Elle n’empêche pas techniquement un agent d’accéder à un hôte situé en dehors du périmètre autorisé. Elle ne peut pas empêcher un opérateur malveillant d’ignorer les règles. Et elle ne peut pas protéger un processus dans lequel l’agent ne charge pas les instructions dès le départ.
Il s’agit d’un garde-fou comportemental, conçu pour augmenter significativement la probabilité qu’un agent IA coopératif respecte le périmètre autorisé, réalise ses tests sans causer de dommages et documente les vulnérabilités avec précision.
Les restrictions techniques doivent toujours être imposées au niveau de l’infrastructure : contrôle des accès réseau sortants, limitation du débit des requêtes (rate limiting), utilisation de données de test et autres mécanismes de sécurité.
Nous ne prétendons pas qu’un fichier Markdown constitue une barrière de sécurité.
Nous nous appuyons sur une méthodologie pour rendre la recherche en sécurité assistée par l’IA plus prévisible, plus reproductible et plus utile.
Mettre les règles elles-mêmes à l’épreuve
Bien entendu, définir des règles pour un agent IA ne suffit pas.
Il faut également vérifier qu’il les respecte.
La Skill est évaluée à travers des scénarios adversariaux : demandes de tests hors périmètre, extraction massive de données, opérations d’écriture destructrices en production, surestimation de la criticité des vulnérabilités ou recours au brute force.
Nous comparons le comportement des agents avec et sans les règles, sur plusieurs exécutions, plutôt que de nous appuyer sur un seul exemple concluant. Cette même suite de tests peut ensuite être utilisée pour réaliser des tests de non-régression à mesure que la Skill évolue.
Le fichier RULES.md reste la source de référence unique, tandis que les fichiers propres à chaque agent sont régénérés pour rester synchronisés. Le processus d’intégration continue (CI) comprend également un mécanisme de détection des secrets.
Car si nous donnons aux agents IA des règles à respecter, nous devons aussi vérifier qu’ils les appliquent réellement.
L’IA fait déjà partie des pratiques de sécurité offensive. Il lui faut désormais une méthodologie.
La question n’est plus de savoir si les chercheurs en sécurité utiliseront des agents IA.
Ils le font déjà.
La véritable question est de savoir comment transmettre à ces agents les bonnes pratiques que les chercheurs et les experts en triage ont développées au fil des années : respecter le périmètre, minimiser l’impact des tests, démontrer ce que l’on affirme, remettre en question ses propres hypothèses et laisser à l’humain la maîtrise de la décision finale.
C’est précisément la raison d’être de la Yogosha Skill.
Le projet est ouvert et accessible à tous.
Le même agent. Avec, désormais, les règles du jeu.